Écrire avec l'IA : ce que la machine fait mieux que moi
On demande si l'IA écrit mes articles. La question vise la partie visible du travail, la rédaction. L'essentiel se joue avant, dans le tri.
La question revient à chaque fois qu’un texte circule un peu : est-ce que c’est vous qui l’avez écrit, ou l’IA ? Elle est légitime. La rédaction est la partie visible du travail, celle qui laisse une trace lisible, celle qu’on imagine quand on pense « écrire ». Si une machine sait produire des phrases correctes, c’est forcément là qu’elle intervient.
Sauf que dans mon cas, ce n’est pas complètement là que ça se joue.
Détection du slop IA et marquage en filigrane
Deux articles examinaient les réponses techniques à cette question : comment reconnaître un texte généré par l’IA (via des tiques stylistiques ou par marquage statistique).
La première est la détection : soumettre un texte à un outil qui estime la probabilité qu’une machine l’ait produit. Elle échoue, et elle échoue mal : les faux positifs frappent préférentiellement les auteurs les plus réguliers, ceux dont le style est le plus stable. Écrire beaucoup et écrire de façon reconnaissable vous désigne comme suspect.
La seconde est le marquage à la source : inscrire dans le texte, au moment de sa génération, une signature statistique qui survivrait à sa circulation. Elle ne tient pas non plus pour une raison structurelle : une réécriture même légère dégrade le signal, et rien n’oblige les fournisseurs à marquer de la même façon. Et quelle serait la probabilité raisonnable au-dessus de laquelle un texte serait disqualifié parce qu’écrit avec une IA ? 10 %, 50 %, 90 % ? Beau sujet pour une dissertation de 4 heures.
Les deux approches partagent une hypothèse qu’aucune ne discute : la réponse serait quelque part dans le texte fini. Il suffirait de savoir la lire.
Un texte achevé ne conserve pas la trace de sa fabrication, pas plus qu’un plat ne conserve la liste de ce qui a été jeté pendant la préparation, sauf si vous êtes un piètre cuisinier et que vous laissez des grumeaux complets dans le plat servi… « Qui a fait quoi » est une propriété du processus, et le processus laisse peu dans le produit fini.
Un texte achevé ne conserve pas la trace de sa fabrication, pas plus qu’un plat ne conserve la liste de ce qui a été jeté pendant la préparation.
Il reste donc une seule source possible : l’auteur. Ce qui suit est ce compte rendu : ce que je délègue, ce que je ne délègue pas, et pourquoi. C’est davantage un témoignage qu’une preuve.
L’essentiel du travail n’est pas où on le cherche le plus
Au moment où j’écris ces lignes, mon inventaire d’idées en attente compte 333 entrées. J’ai publié 25 articles et 80 en « WIP » (work in progress) dans mon kanban éditorial.
Une idée sur treize devient un texte pour l’instant. Les douze autres restent en attente, sont fusionnées, ou meurent parce qu’elles n’avaient pas d’angle ou maturent lentement (je publie un article tous les 8/10 jours, et ce dispositif a l’énorme avantage de tuer l’angoisse de la page blanche et d’avoir un « vide-poche » pour les idées qui sont captés par mon système de veille ou mes réflexions). Ce tri, c’est l’opération la plus coûteuse du processus, et c’est celle dont peu de personnes parlent, parce qu’elle ne produit rien de visible. Un article publié montre le résultat d’une décision. Il ne montre pas les douze décisions inverses qui l’ont précédée (et c’est tant mieux pour le lecteur).
Je ne suis pas seul à faire ce constat. Bertrand Duperrin, qui publie à une cadence beaucoup plus soutenue que la mienne, formule la même chose en cinq mots dans un texte sur l’écriture régulière ↗ : « publier n’est pas écrire ». Il ajoute que « la feuille blanche n’existe pas », parce que le travail réel a eu lieu bien avant, dans l’accumulation et la sélection. Nos volumes (et notre longévité) n’ont rien à voir et la comparaison serait malhonnête. Mais je partage son point de vue sur la localisation du travail.
Que fait la machine, exactement ?
La plupart des descriptions d’usage de l’IA distinguent deux régimes : ce que la machine accélère, et ce que l’humain juge. Cette partition est un peu trop grossière à mon goût. Elle range dans la même case la machine qui produit quelque chose et la machine qui conteste quelque chose, alors que ces deux gestes n’engagent pas du tout la même chose de ma part. Je préfère en distinguer trois :
-
Le mode « délégué » : la machine produit un artefact, j’arbitre. Elle remonte des sources et ce qu’elles ne couvrent pas, elle relie un texte neuf au reste du corpus, elle vérifie des listes de contrôle, elle repère les fautes de typographie. Je retiens ou j’élimine.
-
Le mode « assisté » : le LLM conteste et j’arbitre. Elle ne propose aucune reformulation, elle nomme un problème et s’arrête là. Un exemple concret : un des contrôles que j’ai mis en place compte, pour chaque section citant plusieurs sources, combien d’entre elles apportent quelque chose que les autres n’apportent pas. S’il en trouve trois pour un seul apport énoncé, il me le signale et ne touche à rien. La décision de couper, de reformuler ou de laisser reste entière. Un second contrôle travaille en amont, sur les sources : pour chacune, il énonce ce qu’elle ne couvre pas et ce qu’elle contredit d’une autre. Il ne tranche aucune des contradictions qu’il remonte. Il me les met sous les yeux, et c’est précisément là que le travail commence. Bref, elle prépare le travail de revue de littérature (quand j’en fais une), sans le faire complètement à ma place.
-
Le mode « Humain seul » : le modèle de langage reste dans son coin. Le choix de l’angle, la relecture, la lecture à voix haute, la phrase finale qui dit ce que je retiens… tout ça est pour moi.
Voici la répartition telle qu’elle est aujourd’hui.
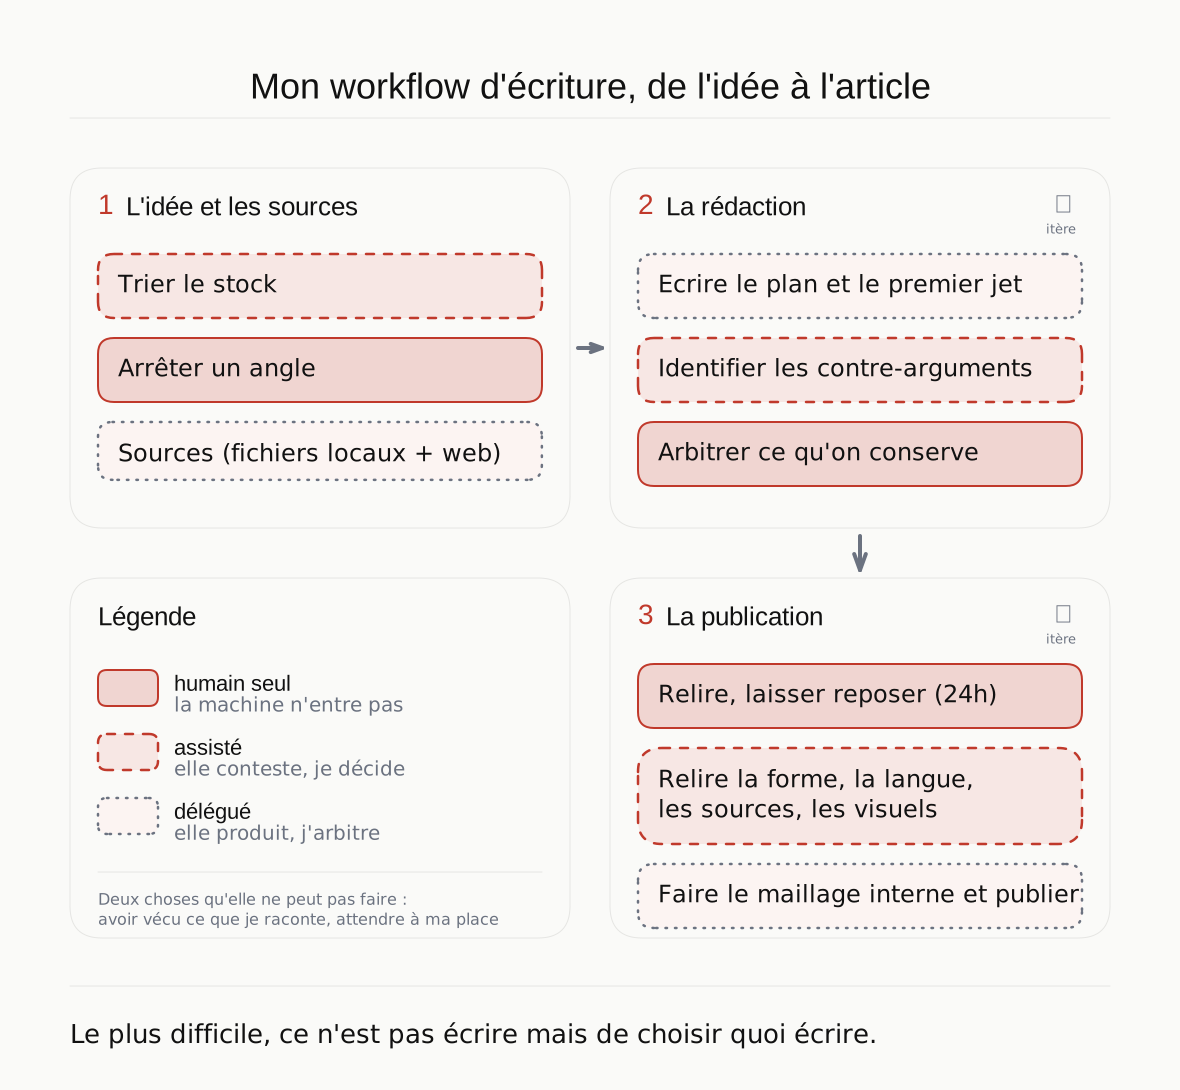
N.B. Pour outiller tout cela, j’ai développé une dizaine de « skills » pour Claude avec mes propres lubies (/deep-source, /spar, /drafting, /write-review…). Il me semblait plus opportun d’achever ce triptyque d’articles sur l’écriture avec l’IA par une vue d’ensemble d’un processus outillé, plutôt que d’ouvrir chacune des « compétences » et prendre le risque de ne parler qu’aux plus technophiles, qui n’écrivent pas forcément.
Ce que la machine fait mieux que moi
C’est ici qu’est l’exercice de bonne foi. Un article qui ne mentionnerait la machine que sur les tâches ingrates serait une mise en scène.
Elle est meilleure que moi pour chercher des sources complémentaires, pour retrouver dans ma propre base documentaire ce que j’y ai « rangé » et oublié (dans ce qu’on appelle parfois un « deuxième cerveau »), pour vérifier une liste de contrôle, pour repérer les fautes de typographie, et pour relier un nouveau texte aux articles précédents selon leur proximité sémantique. Cinq usages sur six relèvent de la même chose : la mémoire et l’endurance. Chercher, retrouver, vérifier, corriger, relier. Rien qui touche au jugement.
Le maillage mérite qu’on s’y arrête, parce qu’il est un peu contre-intuitif. On suppose que la valeur de la machine est de fournir ce qu’on n’a pas. Ici, elle restitue ce que j’ai déjà : tenir un corpus d’articles en tête pour savoir lequel appelle celui-ci est un problème de volume. J’y échoue parce que ça me coûte beaucoup en mémoire au regard de ce que ça produit, et ma relecture me permet d’identifier des rapprochements saugrenus.
Le sixième usage est d’une autre nature : le LLM conteste mes idées mieux que je ne les conteste moi-même. Parmi les articles à paraître d’ici la fin de l’année (je l’espère), il y en a un sur « pensée contre soi-même avec la machine ». Soucieux de contourner mes propres biais cognitifs, j’ai développé un ensemble de prompts (transformés en commandes personnalisées ou « skills ») pour systématiser l’approche antagoniste. L’IA devient alors une sorte de sparring partner pour traquer les failles de raisonnement, les angles morts, la pertinence de la thèse opposée, la faiblesse de la rhétorique (j’ai d’ailleurs appelé ce skill « /spar »).
C’est ce que propose cette séquence ? Un modèle de langage qui ne produit rien et ne corrige rien, mais qui s’oppose, qui questionne par vague de cinq interrogations. le LLM questionne, je réponds… Je relance autant de tours que nécessaires. Ouf ! Je n’en ai jamais lancés plus que trois sur un même article…
Le même geste, à deux moments différents
C’est aussi l’endroit où nos pratiques (avec Bertrand Duperrin) se séparent, et l’écart est plus instructif qu’un désaccord. Dans son article sur l’écriture avec l’IA ↗, il décrit une IA qui arrive quand tout est fini : « elle n’écrit pas à ma place mais m’aide à publier un article que j’ai déjà écrit ». Elle vérifie des statistiques, retrouve des études, et, il le mentionne, cherche les angles morts de son argumentation.
Ce dernier point est exactement mon régime assisté. Nous faisons donc le même geste à deux moments différents : il fait contester un texte achevé, je fais contester une thèse qui n’est pas encore complètement écrite. Le sparring attaque le raisonnement pendant qu’il se construit, quand il est encore assez souple pour céder.
Nous partageons aussi l’approche amont, avec des notes accumulées plus ou moins structurées bien avant qu’il soit question de rédiger. C’est ce qui rend l’écart lisible : il ne porte ni sur ce que vaut l’outil, ni sur la quantité de travail humain. Il porte sur le moment où on laisse la contestation entrer, et donc sur ce qu’on accepte qu’elle démolisse. Personnellement, je pense que « au plus tôt, au mieux » : si je passe trop de temps sur la structuration d’un papier, je vais avoir tendance à « m’attacher » davantage à mes idées et ça pourrait me coûter de les abandonner. L’honnêteté intellectuelle a ses limites, quand on est un peu orgueilleux. 😉
Deux gestes qu’aucune machine ne peut faire
Il y a dans mon processus deux points où la question de la délégation ne se pose même pas.
Le premier est une règle que je me suis donnée : un article doit contenir au moins une donnée, un fait que j’ai produit. Une mesure sur mon propre système, un incident daté, un arbitrage avec son coût… Une formule vague (« dans mes missions ») ne compte pas, elle affirme une expérience sans la rendre vérifiable. Une citation externe, même impeccablement sourcée, ne compte pas non plus.
Aucune machine ne peut satisfaire cette condition, et c’est ici que l’article se retourne sur lui-même. Elle peut chercher, rédiger, contester, vérifier.
Cette exigence de vécu est aussi un critère de référencement sur Google (le fameux EEAT : Expérience, Expertise, Autorité, Trust, trust au sens de fiabilité) : les moteurs valorisent l’expérience de première main, donc tout le monde a intérêt à en afficher. Mais il suffirait de cadrer un persona pour obtenir des incidents datés, des arbitrages chiffrés, des mesures plausibles, cohérents, bien écrits, et… faux. Rien dans le texte fini ne les distinguerait des miens.
La règle protège donc ce que j’écris, pas ce que vous lisez. Elle sépare le vrai du vraisemblable de mon côté ; du vôtre, les deux se ressemblent. C’est le constat des deux articles précédents.
Le second est encore plus trivial : entre le moment où je finis de relire et celui où je considère le texte prêt, j’attends en général vingt-quatre à quarante-huit heures sans y toucher. Aucun outil ne peut attendre à ma place. Un LLM n’a pas besoin d’attendre, au-delà des délais d’exécution de ses tâches (ou quand l’infrastructure est perturbée).
La vue d’ensemble
Reste une question que le tableau ci-dessus ne traite pas : comment tient-on 333 idées en tête ?
On ne les tient pas. Il faut une vue qui les embrasse toutes. Pour m’aider à appréhender cette vue panoramique que j’ai fini par construire, sous la forme d’un tableau de suivi, un kanban, adossé au reste de mon dispositif de veille. Ce kanban facilite l’arbitrage avant qu’il y ait quoi que ce soit à écrire mais ce n’est pas une pièce de mon workflow d’écriture à part entière.
Ce kanban a une double fonction de backlog, vide-poche, il me permet d’avoir une vue globale sur l’état de maturation de mes notes. N’importe quel outil de marché pourrait faire le travail, j’ai préféré personaliser une interface pour mieux le lier à mon processus de veille (quand j’analyse une source, mes commandes personnalisées me proposent de nouvelles idées que j’intègre ou non…).
Si je m’attarde un peu là-dessus, c’est pour une raison qui n’a rien à voir avec l’outillage. On ne construit pas une vue d’ensemble pour une activité dont l’essentiel serait la rédaction. On la construit parce qu’il y a un stock à maturer. J’ai évoqué le syndrome de la page blanche plus haut. Il n’existe quasiment pas parce que je dispose déjà d’un stock de brouillons et de notes conséquent.
Et c’est là que la répartition cesse d’être la mienne pour devenir potentiellement transposable.
Ce que je me demande avant d’écrire
Il y a une chose de mon processus que vous pouvez reprendre telle quelle, sans rien installer, et c’est probablement la seule qui vaille le déplacement.
Avant d’écrire, je fais passer l’angle par cinq questions :
- Thèse contestable : quelqu’un d’intelligent et informé pourrait-il être en désaccord ?
- Mécanisme surprenant : le lecteur serait-il surpris par l’explication ?
- Ancrage personnel : y a-t-il une phrase qui pourra commencer par « dans mon expérience » ou « j’ai observé que » ?
- Non-interchangeabilité : si on remplace le sujet par un autre, le texte tient-il encore ?
- Ligne mémorable : y a-t-il une phrase qu’on citerait ?
Deux « non » ou plus, et je retravaille l’angle avant d’écrire une ligne. Je ne la recommande à personne, mais je l’applique moi-même à chaque fois. Elle ne nécessite ni outil ni abonnement.
J’y ajoute un test d’abandon emprunté à Paul Graham ↗, qui distingue quatre facteurs dans un texte utile :
-
l’exactitude,
-
la nouveauté,
-
l’importance,
-
la conviction.
Sa remarque décisive est que ces facteurs se multiplient au lieu de s’additionner. Un texte irréprochable, nouveau et important mais écrit avec des précautions partout ne vaut rien, parce que le zéro d’un facteur annule tous les autres. Je passe ce test au cadrage, quand abandonner le sujet coûte symboliquement peu, puisque j’y ai passé peu de temps.
Quiconque découvre ces outils y verra où porter l’effort : pas sur la rédaction, qui s’améliore vite, mais sur le tri, qui ne s’améliore qu’avec le jugement.
Ce que j’en retiens
Ce découpage a l’air arbitraire si on le lit comme une liste de tâches. A mes yeux, il ne l’est pas.
Écrire sert à clarifier ce qu’on pense. Ce n’est pas une formule, c’est ce qui se passe quand une idée qu’on croyait claire résiste à la mise en phrase, et qu’on découvre en écrivant qu’on ne la tenait pas vraiment. Déléguer l’écriture revient donc à déléguer la clarification, c’est-à-dire à obtenir un texte sans avoir fait le travail qui devait le produire.
Voilà pourquoi certaines cases restent humaines. Pas par principe ou par attachement à un artisanat quelconque mais parce que ce sont celles où la pensée se forme, et qu’un texte qui sort de là sans que rien ne se soit formé n’a pas de raison d’exister. J’avais posé ailleurs le critère qui permet de trancher, l’intention compositionnelle, et je n’y reviens pas. Ce texte-ci en est l’application.
Pour résumer, le gros du travail n’est pas d’écrire mais de choisir quoi écrire.
Les opinions exprimées ici sont personnelles et n'engagent pas mon employeur.