Mon meilleur prompt pour votre rentrée 2026
Les modèles récents suivent une instruction à la lettre. Le gabarit de prompt qui marchait il y a 18 mois vous dessert désormais.
La dernière fois que j’ai écrit « sois exhaustif » dans un prompt, Claude a produit dix pages sur un sujet qui en méritait trois. Attention aux mots flous ou ceux pour lesquels l’IA a une définition différente de la vôtre.
Un gabarit en quatre blocs (objectif, périmètre et localisation des sources, format attendu, critères de succès) remplace les anciens réflexes qui dégradent désormais la sortie : les règles absolues (« toujours », « jamais »…), les mots vagues (« professionnel », « exhautif », « élégant », « synthétique »…), les injonctions à réfléchir plus profondémment (« think harder », « réfléchir étape par étape »…). Pour les tâches orchestrées à plusieurs agents, une variante en trois blocs prend le relais ; pour les lancements de phase complexes, l’inverse marche mieux : moins de structure, plus de dictée libre.
Sur mes projets, cette phase revient chaque semaine, sous une forme ou une autre : le modèle n’a pas mal compris, il a compris trop bien. « Détaillé » est devenu douze pages parce que je n’ai jamais dit ce que « détaillé » voulait dire pour moi. La documentation officielle d’Anthropic sur Claude Sonnet 5 ↗ confirme le phénomène : une section entière s’intitule « More literal instruction following » (suivi plus littéral des instructions). Le modèle n’invente plus le contexte manquant, il l’exécute au pied de la lettre, un prolongement direct du mécanisme de prédiction qui gouverne tout LLM.
C’est un changement de comportement qui rend obsolètes des réflexes de prompt engineering (ingénierie de prompt) qui fonctionnaient parfaitement il y a dix-huit mois. Les modèles précédents, moins littéraux, faisaient des suppositions raisonnables sur ce qu’on voulait dire. Les modèles actuels ne devinent plus : ils exécutent ce qu’on écrit, exactement. Ils sont plus scolaires en quelque sorte (d’où cette idée d’article de prompt de rentrée : quelques conseils directement applicables pour les situations qui méritent les meilleures réponses de votre LLM préféré).
1. Un OSSS qui remplace les anciens réflexes
OSSS est le procédé mnémotechnique que je vous propose pour les tâches importantes (expliquer un incident, rédiger un rapport, résumer une réunion…). En septembre 2026, en l’état de mes tests et de mon expérience, la structure la plus fiable tient en quatre blocs.
-
Le premier bloc est l’objectif (O), pas seulement la tâche. Demander « analyse ces logs » laisse le modèle deviner pourquoi. Ajouter « je dois présenter la cause racine à un comité qui n’était pas dans la salle » change tout : le modèle sait désormais quoi prioriser (le fil causal) plutôt que de choisir à ma place (l’inventaire des erreurs rencontrées).
-
Le deuxième bloc identifie la source (S) et délimite où chercher plutôt que de tout déverser. Sur un document de deux cents pages, extraire les douze pages pertinentes vaut mieux que tout transmettre en espérant que le modèle filtre lui-même. Quand l’extraction n’est pas possible, pointer la zone d’intérêt suffit : « voici le fichier, tout s’est joué entre 14h et 16h, concentre-toi là-dessus. »
-
Le troisième bloc définit la sortie attendue (S) - l’output. Une page ou dix ? Ton formel ou direct ? Le silence sur ce point est le premier endroit où un modèle littéral choisit à ma place, et rarement comme je l’aurais fait.
-
Le quatrième bloc pose les critères de Succès - Definition of Done : à quoi je reconnais que c’est terminé, réussi, suffisant. C’est le bloc qu’on croit décoratif jusqu’au jour où il retourne la sortie : « le comité doit comprendre sans moi » produit un texte que « analyse ces logs » ne produira jamais, à objectif, sources et format identiques.
Retenez l’ordre avec un acronyme : OSSS, pour Objectif, Sources (où le LLM doit chercher prioritairement), Sortie/Output (la forme attendue), Critère de Succès (Definition of done). Voici ce que ça donne sur l’incident cité plus haut :
Objectif : présenter la cause racine au comité jeudi.
Sources : les logs joints, fenêtre 14h-16h du 12.
Sortie : une chronologie, puis la cause en 5 lignes.
Critères de succès : le comité doit comprendre sans moi.
Ces quatre blocs ne sont pas un formulaire administratif. Ils ressemblent, d’assez près, à ce que le linguiste Austin appelait, dans Quand dire, c’est faire ↗ (1962), les « conditions de félicité » d’un acte de langage (parole performative) : les conditions qui font qu’un énoncé produit réellement l’effet visé, plutôt que de rester un énoncé sans prise sur le réel. Un ordre mal formé n’est pas un mauvais ordre mais un acte qui n’a pas eu lieu. Un prompt sans objectif, sans périmètre, sans forme attendue, sans critère de succès n’est pas un mauvais prompt. C’est une requête qui n’a pas vraiment eu lieu comme on l’attendait, même si le modèle répond quand même à quelque chose mais à côté de ce qu’on avait en tête, comme une mayonnaise qui ne prend pas.
2. Ce que le gabarit ne peut pas anticiper
Ce gabarit réduit les décisions implicites du modèle mais ne les supprime pas. Même bien cadré, un prompt laisse le modèle trancher silencieusement des points qu’on n’a pas explicitement couverts : que faire d’un mot resté ambigu, comment arbitrer deux données contradictoires dans la source, quelle section omettre du résultat sans le signaler. Cette dernière catégorie, l’omission silencieuse, coûte le plus cher en pratique : on ne la découvre qu’en relisant la source ligne par ligne à côté de l’output, ce qui annule une bonne partie du gain de temps promis par l’IA.
Le filet de sécurité tient en une phrase à ajouter au prompt :
Rédige un journal de chaque décision que tu prends sans que
je l’aie explicitement précisée.
Lire ce journal avant le fichier de sortie révèle en quelques secondes ce que le modèle a tranché à ma place. La plupart du temps (environ 80 % des cas), la décision est bonne ou meilleure que celle que j’aurais prise moi-même. Le reste se corrige, et quand la même dérive revient sur des tâches similaires, la correction va dans l’instruction elle-même, pas dans un rattrapage ponctuel (c’est ce mouvement qui fait converger le gabarit vers un état stable dans le temps).
Ce nouveau bloc n’annule pas les quatre premiers, il les complète différemment : le gabarit cadre la demande en amont, le journal de décisions rend visible ce qui s’est décidé en aval, malgré le cadrage.
3. Trois catégories de mots à retirer
Trois familles de mots dégradent aujourd’hui ce qu’elles étaient censées renforcer.
- La première regroupe les mots ou les règles absolus : toujours, jamais, doit… Un modèle littéral qui lit « ne fais jamais X » sacrifie tout le reste du prompt pour respecter cette règle à la lettre. La documentation Anthropic donne l’exemple exact de ce glissement dans son guide de migration : remplacer « CRITICAL : tu DOIS utiliser cet outil quand… » par un simple « utilise cet outil quand… » corrige un comportement de sur-déclenchement observé sur les modèles récents. La structure de remplacement est une condition, pas une interdiction : « si un maillon de la chaîne manque dans les logs, écris “non établi” plutôt que de combler » laisse au modèle une porte de sortie que l’absolu lui refusait. Trois lignes suffisent à illustrer :
Si un maillon de la chaîne manque dans les logs, écris
"non établi" plutôt que de combler.
Si un horodatage n'est pas dans le fichier fourni, écris
"non trouvé", ne devine pas.
Si ma demande n'est pas claire, pose-moi une question avant
de commencer.
J’ajoute la dernière dans quasiment tous mes prompts structurants. Le modèle a tendance à poser quand même des questions dans ce cas. Mais l’usage préventif l’encourage à le faire systématiquement et à passer plus de temps dans l’action qu’à la sur-analyse du prompt initial.
-
La deuxième catégorie regroupe les mots flous : « détaillé », « professionnel », « résumé », « cool ». Chacun porte une définition implicite propre à celui qui écrit, que le modèle ne partage pas forcément. Mon « détaillé » est une page ; celui du modèle peut en faire douze. La solution tient en deux options : définir explicitement ce que le mot signifie ici, ou donner éventuellement un exemple à imiter plutôt que de le décrire (donner un exemple n’est pas l’approche la plus efficace dans ma pratique. Je préfère donner la définition de ce qui est attendu que d’inventer ou retrouver un exemple qui me convient).
-
La troisième catégorie regroupe les incitations à réfléchir davantage : think harder, think step by step. Ces formules, utiles il y a deux ans, sont devenues une distraction pour les modèle. Le contrôle de l’intensité de raisonnement est désormais un réglage produit, pas une formule dans le prompt : le paramètre
effortchez Anthropic (low/medium/high/extra/max), le niveau de réflexion chez OpenAI et Google. La documentation dédiée au paramètreeffortest explicite sur ce déplacement : ajuster ce réglage plutôt que d’essayer de l’obtenir en le demandant dans le texte. Point à ne pas confondre : l’intensité de réflexion n’est pas corrélée à la longueur de la réponse, un modèle peut réfléchir longtemps pour répondre en trois lignes, ou l’inverse.
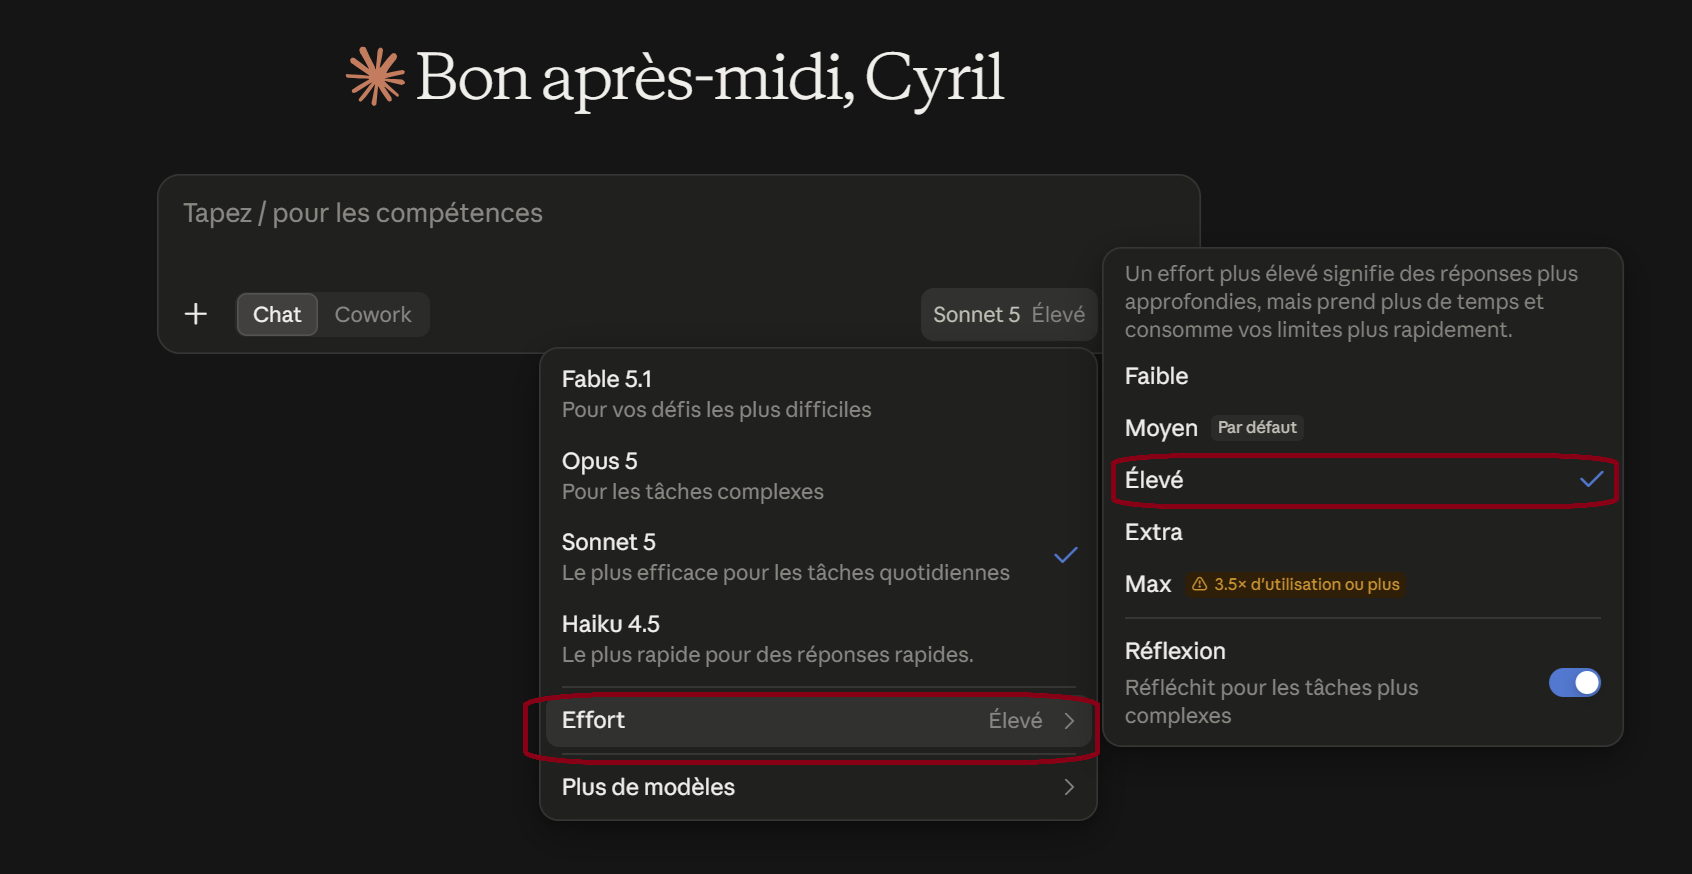
Sélection de l’effort de calcul dans Claude
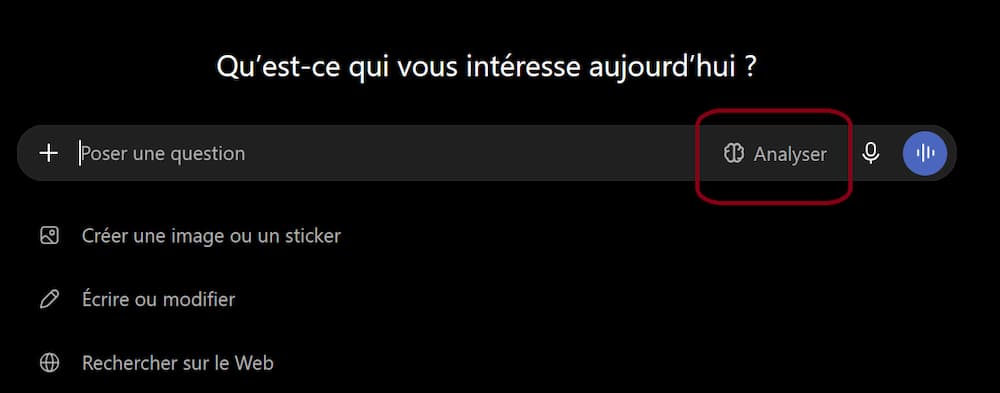
Sélection de la profondeur de réflexion dans ChatGPT
Un rapport technique du Wharton Generative AI Labs (Meincke, Mollick, Mollick & Shapiro, 2025) ↗ avait déjà chiffré ce déplacement un an avant que les vidéos ne le documentent en pratique, sur un benchmark de 198 questions de niveau doctorat (GPQA Diamond) : sur les modèles à raisonnement (o3-mini, o4-mini, Gemini Flash 2.5), demander explicitement un raisonnement pas à pas ne rapporte que de -3,3 % à +3,1 % selon le modèle, parfois négatif, pour un surcoût de temps de 20 à 80 %. Le pari était le plus souvent perdant.
4. « Un gabarit rigide de plus » ?
L’objection vient naturellement : n’ai-je pas simplement remplacé une instruction rigide par une autre ? Le gabarit à quatre blocs impose lui aussi une forme, alors pourquoi échapperait-il au reproche fait aux règles absolues ?
L’objection confond deux niveaux. Le gabarit contraint les conditions de la demande (ce qu’il faut préciser pour qu’une requête ait une chance d’aboutir). Les règles absolues contraignent le contenu de la réponse elle-même, en imposant un comportement quel que soit le contexte rencontré. Le premier laisse le modèle décider comment répondre ; le second lui interdit certaines réponses avant même qu’il les évalue. C’est cette distinction que confirme, plus loin dans cet article, le déplacement vers la dictée libre pour les tâches les plus complexes : la structure s’efface complètement quand le grain de la tâche change, ce qu’une contrainte rigide ne ferait jamais.
5. Pour aller plus loin, quand la tâche est encore plus complexe : le gauntlet loop
Pour les tâches qui dépassent le prompt simple, une variante plus lourde a émergé récemment autour de Claude Opus 5 : le gauntlet loop. La technique, popularisée par Matt Schumer ↗ : un jeu vidéo 3D complet généré en un seul prompt, sans aucun asset externe.
Claude Opus 5 one-shotted this game.
, Matt Shumer (@mattshumer_) July 25, 2026
EVERYTHING you see in this demo is custom code... not a single external asset was used.
AI games are going to be amazing.
(sound on) pic.twitter.com/zc7C61kgv1
La structure tient en trois blocs, distincts de ceux du gabarit précédent et à tester avec les modèles les plus avancés (ChatGPT Astra ou Fable 5.1 - attention, ça consomme beaucoup de tokens). Le premier bloc pose la tâche, comme précédemment. Le deuxième décrit la méthode de construction : demander à l’agent principal de répartir le travail vers une flotte de sous-agents, chacun assigné à une portion du travail et évalué par un agent critique dédié qui vérifie visuellement le résultat. Le troisième bloc fixe la barre à atteindre : un critère d’arrêt qualitatif et itératif plutôt qu’une liste statique de critères, du type « ne t’arrête pas tant que chaque critique n’est pas pleinement convaincu ».
Construis un jeu de tir à la première personne au niveau des
jeux Call of Duty les plus récents. Il devrait être absolument
parfait, visuellement magnifique, avec chaque détail fait en
qualité AAA (des textures à la physique en passant par tout ce
que tu pourrais imaginer).

Déploie des sous-agents et fais en sorte que les sous-agents
s’occupent chacun d’une chose individuellement pour que le jeu
soit absolument parfait. Tu devrais boucler sur chaque élément
et faire en sorte qu’un sous-agent séparé le vérifie
visuellement pour s’assurer que cela semble triple A. Ce
sous-agent séparé devrait être un critique vraiment impitoyable,
et s’il ne semble pas triple A, il devrait continuer.

N’arrête pas tant que chaque sous-agent n’est pas absolument
impressionné par la qualité comparée au jeu Call of Duty réel.
Il devrait littéralement les comparer côte à côte en aveugle et
dire lequel semble meilleur. Fais ceci en ThreeJS. Boucle
jusqu’à ce que ce soit absolument parfait. Déploie des
sous-agents et ultracode.
Ce n’est pas une nouveauté totale : Anthropic documentait déjà, dans son article Building Effective Agents ↗ de 2024 , qu’un modèle évaluateur distinct améliore la qualité par rapport à une auto-évaluation. Ce que le gauntlet loop pousse à l’extrême, c’est l’échelle : plusieurs agents, chacun avec son critique, orchestrés en boucle jusqu’à satisfaction du critère fixé.
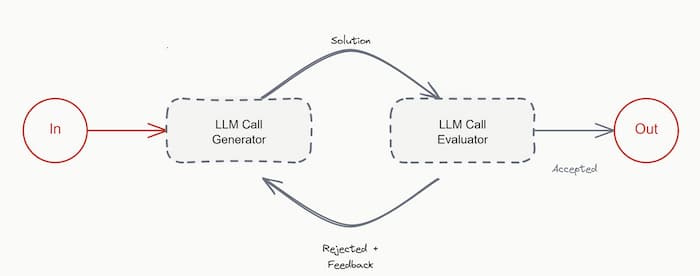
Boucle générateur/évaluateur
La nuance compte autant que la technique. Sans un produit minimum viable ou un système de design déjà cadré en amont, le gauntlet loop optimise vers la mauvaise cible : le résultat peut être visuellement impressionnant et complètement hors sujet par rapport à l’intention initiale. Le format consomme aussi beaucoup de temps et de tokens, plusieurs heures pour certains runs. La bonne place pour cette technique n’est donc pas le premier prompt d’un projet, mais le polissage d’une version déjà cadrée : un accélérateur de qualité, pas un point de départ (le harness compte plus que le modèle : ici aussi).
Et pour les projets qui commencent dans le flou
Un dernier cas échappe complètement à la logique de structuration présentée ici : celui où le projet est encore trop flou pour être découpé en objectif, périmètre, forme et critères. Andrej Karpathy ↗, aujourd’hui membre de l’équipe de recherche d’Anthropic, décrit sur X un usage à l’exact opposé du gabarit : quand le modèle a besoin de « plus de bits » pour comprendre l’intention que pour les taper, il bascule en dictée vocale et divague en flux de conscience pendant une dizaine de minutes. Sa remarque centrale : les LLM excellent à reconstruire de la cohérence depuis une pensée décousue, au point que leur écho ressort souvent plus clair que ce avec quoi on a commencé, ce qui réduit d’autant le besoin de corriger ensuite.
Le choix ne dépend pas d’une hiérarchie de qualité entre le gabarit, le gauntlet loop et la dictée libre, mais du grain de la tâche : cadrée, structurer ; encore floue, divaguer et laisser le modèle faire le tri.
Ce que ça change selon votre usage
Oubliez (vraiment) les techniques apprises il y a plus de 18 mois. Arrêtez de donner un rôle à votre LLM : ça ne sert plus à rien, et ça le distrait. Expliquez-lui le « pourquoi » de votre demande, où chercher, ce que vous attendez en sortie et à quoi vous reconnaîtrez que c’est réussi. Ajoutez le journal de ses décisions implicites. Voilà le prompt à copier-coller et à assaisonner à votre goût.
# Objectif
Présenter la cause racine de l'incident au comité de jeudi.
Ces gens n'étaient pas dans la salle et ne liront pas de logs.

# Sources
Les logs joints, fenêtre 14h-16h du 12. Ignore le reste du
fichier, même si tu y vois des erreurs.

# Sortie
- Une chronologie des faits, heure par heure.
- La cause racine en 5 lignes maximum.
- Un journal séparé listant chaque choix que tu as fait sans
  consigne explicite de ma part.

# Critères de succès
Le comité doit comprendre sans moi dans la salle. Chaque terme
technique est traduit une fois, à sa première apparition.
Si un maillon de la chaîne manque dans les logs, écris
"non établi" plutôt que de combler.

# Explicitation
Si ma demande reste ambiguë, pose-moi une question avant de
commencer.
Télécharger la fiche de synthèse en PDF — le gabarit et le prompt sur une page, à garder ouverte quand vous écrivez un prompt.
Ce que j’en retiens
La compétence de prompting ne s’accumule pas comme un capital qu’on empile. Elle se recalibre à chaque changement de comportement du modèle. Ce qui fonctionnait hier peut nuire aujourd’hui, sans qu’aucune annonce officielle ne le signale. La seule façon de le savoir est de comparer, régulièrement, ce qu’un prompt qui a fait ses preuves produit sur le modèle du moment face à ce qu’il produisait il y a six mois. En septembre 2026, un prompt n’est pas une liste de consignes envoyées à un chatbot, c’est une conversation avec quelqu’un qui vous prend au pied de la lettre, de façon scolaire.
Ce gabarit rend service une fois qu’on a compris à quoi il sert. Si vous partez de zéro sur le fonctionnement des LLM, le parcours « Par où commencer » ordonne les articles du site selon votre profil.
Les opinions exprimées ici sont personnelles et n’engagent pas mon employeur.
Les opinions exprimées ici sont personnelles et n'engagent pas mon employeur.